armlink 应用指南
版本 |
日期 |
作者 |
修改说明 |
|---|---|---|---|
1.0 |
2025-06-06 |
初始版本 |
一、引言
armlink 作为 ARM 开发工具链中的核心链接器,在嵌入式系统开发等领域发挥着至关重要的作用。 其核心功能是将编译器生成的目标文件链接为单一的可执行文件,同时支持通过链接脚本对内存布局进行精细控制。 本应用指南介绍et6x系列MCU开发中较为通用的 armlink 的各项功能、使用方法及优化技巧,助力开发者充分发挥 armlink 的优势,提升开发效率与产品性能。
二、armlink 工具基础
功能特性
文件链接:可高效地将多个目标文件(如 .obj 或 .o 文件)以及库文件链接成一个完整的可执行文件,确保程序在运行时各部分能协同工作。
内存布局控制:通过链接脚本,开发者可以精确指定代码段、数据段、未初始化数据段等在内存中的位置和大小,满足不同硬件平台和应用场景对内存使用的特定需求。 例如,对于一些对实时性要求极高的嵌入式应用,可以将关键代码段放置在高速内存区域,以减少访问延迟。
符号解析与管理:在链接过程中,armlink 负责解析程序中各个符号的引用,确保函数名、变量名等符号在不同编译单元之间的正确匹配和使用。 同时,支持对符号的可见性进行控制,方便进行模块化编程和库的构建。
代码优化:armlink 具备一定的代码优化能力,能够对链接后的代码进行优化处理,如消除未使用的代码和数据,减少可执行文件的体积。 通过优化指令序列,提高代码的执行效率,在不影响功能的前提下,使程序运行更加高效。
与其他工具的关系
armlink 是 ARM 开发工具链的重要组成部分,与 ARM 编译器(如 armcc)紧密配合。编译器负责将源代码编译为目标文件,而 armlink 则将这些目标文件和相关库文件链接成可执行文件。 同时,它与调试器(如 ARM Debugger)也存在关联,调试器需要依赖 armlink 生成的可执行文件和.map 文件进行程序调试和分析,三者相互配合,共同构成了完整的 ARM 开发流程。
三、.sct使用流程与操作指南
在正式使用链接脚本文件前,需要了解链接脚本文件的对应芯片的内存分配情况。et6x 系列 MCU 部分产品为双核配置,部分产品为单核配置,不同配置下的芯片的内存分配情况并不一 致。但他们都一样拥有以下内存区域:
内存
et6001(cpu1、cpu2相同)
et6002/et6039
et6025
ITCM
0x00000000 ~ 0x0000FFFF
0x00000000 ~ 0x00007FFF
0x00000000 ~ 0x00007FFF
DTCM
0x20000000 ~ 0x2000FFFF
0x20000000 ~ 0x20007FFF
0x20000000 ~ 0x20007FFF
PFLASH0
0x08000000 ~ 0x0807FFFF
0x08000000 ~ 0x0803FFFF
0x08000000 ~ 0x0803FFFF
PFLASH1
0x08080000 ~ 0x080FFFFF
0x08040000 ~ 0x0807FFFF
无
DFLASH
0x10000000 ~ 0x1001FFFF
0x08080000 ~ 0x0809FFFF
无
SRAM0
0x20400000 ~ 0x2040FFFF
0x20400000 ~ 0x2040FFFF
0x20400000 ~ 0x2040FFFF
SRAM1
0x20410000 ~ 0x2041FFFF
0x20410000 ~ 0x20417FFF
无
SRAM2
0x20420000 ~ 0x2042FFFF
无
无
SRAM3
0x20430000 ~ 0x2043FFFF
无
无
在keil中使用链接脚本文件
在使用 armlink 时,链接脚本至关重要,其中 .sct 文件(Scatter-Loading File,分散加载文件)是一种常见的链接脚本形式。 IAR中为.icf文件,其格式与.sct文件类似,但语法有所不同。以下内容以.sct文件为例,介绍链接脚本文件的使用。
.sct 文件用于精确指定映像文件内部各区域在加载与执行时的位置。其基本结构由一系列加载区域(Load Region)和执行区域(Execution Region)定义组成。 每个区域通过特定的语法进行描述,以一个头标题开始定义,头中至少包含区域的名字(开发者自定义)和起始地址,如LR_IROM1 0x08000000定义了一个名为LR_IROM1的加载区域,起始地址为0x08000000。 另外,还可指定最大长度等其他一些属性选项(这些属性是可选的)。
分散加载文件语法规则
一个散列文件包含一个或多个加载区域,每个加载区域可以包含一个或多个执行区域。
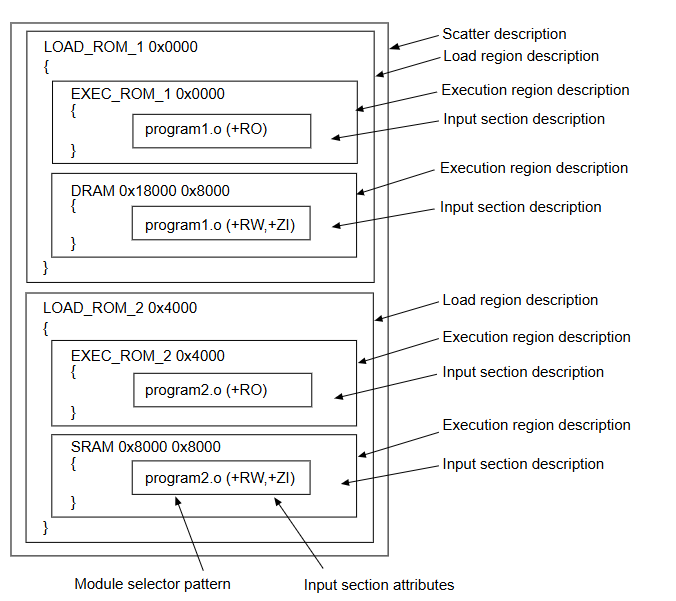
一个加载区域的标准形式为:
加载域名 (基地址 | ("+"地址偏移(+<offset>))) [属性列表] [最大容量]
{
  执行域名 (基地址 | ("+"地址偏移(+<offset>))) [属性列表] [最大容量 | <length>]
  {
      模块选择模式(+输入节区属性)
      模块选择模式(输入符号样式)
      模块选择模式(输入节区样式)
  }
}
域名:用于链接器识别不同的域。
基地址:指定加载域中代码和数据的起始地址,地址偏移为可选内容,偏移地址必须满足对齐要求。<offset>表示地址位于前一个加载区域的末尾之后<offset>字节的位置。如果这是第一个加载区域,加载区域的起始地址不依赖于任何先前的加载区域,<offset>表示基地址距离零点<offset>字节。
属性:指定加载域的属性,常见的属性如下:
ABSOLUTE———————————-绝对地址(默认)
ALIGN <alignment>————————-地址对齐
NOCOMPRESS——————————–指定某个加载区域内容在镜像文件中不被压缩
EMPTY [-]<length>————————在执行区域中保留一个给定大小的空内存块,通常由堆栈使用。在具有 EMPTY 属性的区域中不能放置节区。 <length> 表示在内存中向下增长的堆栈长度。如果长度为负值,则 <base_address> 被视为区域的结束地址。
FIXED————————————–固定地址。链接器尝试使执行地址等于加载地址。
最大容量:指定加载域的最大大小。如果指定了可选的 max_size 值,则如果该区域分配给它的字节数超过 max_size,armlink 将生成错误
输入节区的常见形式如下:
模块选择模式(+输入节区属性)
模块选择模式(输入符号样式)
模块选择模式(输入节区样式)
模块块选择模式:
可以使用通配符字符” * ”与.ANY,使用.ANY 可以选择所有的.o 文件与.lib 文件,其中.ANY 选择的文件是优先级最低的。
使用”.o”可以选择所有.o 文件。
使用”.lib”可以选择所有.lib 文件
输入节区属性(不区分大小写):
属性 |
说明 |
使用示例 |
|---|---|---|
RO -CODE/CODE |
只读代码段(程序令) |
|
RO- DATA/CONST |
只 读数据段(常量/const修饰的变量) |
|
RO/TEXT |
只读属性
(等效 |
|
RW-CODE |
可读写代码段 |
|
RW-DATA |
可读写数据段 |
|
RW/DATA |
可读可写(已初始化数据,
等效 |
|
ZI/BSS |
零初始化 (未初始化变量,运行时自动清零) |
|
XO |
可执行不加载(节省 Flash) |
|
FIRST |
优先级最高(区域起始) |
|
LAST |
优先级最低(区域末尾) |
|
输入节区样式:
例如:InRoot$$Sections:用于定义特定段的符号,用于将某些节放置在特定的内存区域。
RESET:通常定义程序的复位向量,当系统上电或复位时,处理器会跳转到该地址执行启动代码
示例及修改
一个简单的 .sct 文件可能包含如下内存区域定义:
LR_IROM1 0x08000000 0x00040000      ; Name of load region (LR_IROM1),
                                    ; Start address for load region (0x08000000),
                                    ; Maximum size of load region (0x00040000)
{
        ER_IROM1 0x08000000 0x00040000      ; Name of first exec region (ER_IROM1),
                                            ; Start address for exec region (0x08000000),
                                            ; Maximum size of first exec region (0x00040000)
        {
            *.o (RESET, +First)
            *(InRoot$$Sections)
            .ANY (+RO)
            .ANY (+XO)
        }
        RW_IRAM1 0x20000000 0x00008000      ; RW data
        {
            .ANY (+RW +ZI)
        }
}
上述代码中, LR_IROM1 定义了位于0x08000000、大小为0x00040000的加载区域,et6x系列mcu中对应于 Flash 存储器。 在该加载区域内,又定义了执行区域 ER_IROM1,这意味着该区域的数据加载到 Flash 后,运行时也在此处执行。其中:
*.o (RESET, +First)表示从所有目标文件(.o文件)中,选取包含RESET属性的内容,并利用 +First 指定优先级,将其放置在 ER_IROM1 区域的最开始位置。 RESET 关联程序启动时的复位向量,如此设置确保系统启动时能优先执行正确的复位操作代码。*(InRoot$$Sections)用于匹配并包含所有标记为InRoot$$Sections的输入段,这些段往往是程序运行必需的关键部分,如特某些 ARM C 和 C++ 库部分必须放置在根区域。.ANY (+RO)表示所有具有只读(Read - Only,+RO),像代码段.text、只读数据段.rodata 等,将它们存放在 ER_IROM1 区域。.ANY (+XO)表示所有具有可执行但不加载(execute Only,+XO )属性的段会被包含在这个执行区域中。
RW_IRAM1 定义了位于0x20000000、大小为0x00008000的执行区域,起始地址为0x20000000,大小为0x00008000(即 32KB),et6x系列mcu中对应于 DTCM 存储器,用于存放可读写数据。其中:
.ANY (+RW +ZI)选取所有目标文件中的可读写数据段(如已初始化的数据段 .data,由 +RW 收集,未初始化数据段 .bss ,由 +ZI 负责收集),程序启动时,系统会自动将 .bss 段清零,保证数据初始状态准确。
修改内存布局
使用 keil 修改内存布局,主要有以下两种方式:
1. 用户在 MDK 工程选项中,选择“Linker”标签页,在“Use Memory Layout from Target Dialog”选项中勾选。 然后,选择“Target”标签页,修改Memory Areas,然后点击编译,即可生成对应的.sct 文件。
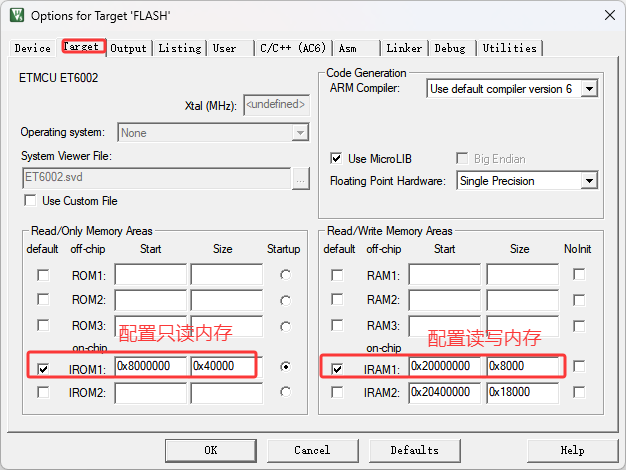
小技巧
例如:若想将工程加载到 ITCM 中,可修改 IROM1 的 start 为 0x00, size 为 0x8000。(此处的start 、size根据实际情况调整)
用户导入sct文件
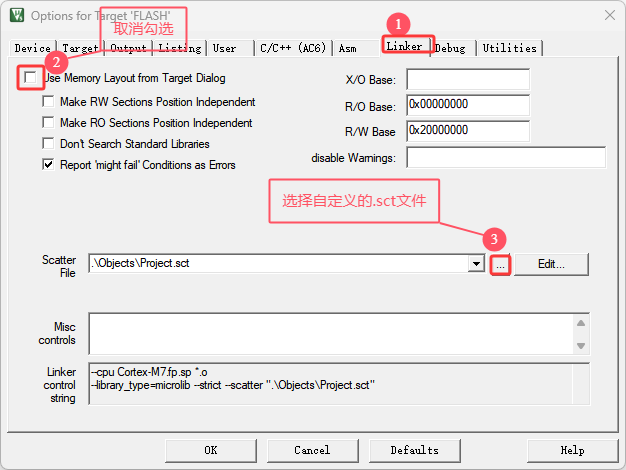
小技巧
可以先使用第一种方式,生成默认的sct文件,然后点击 Edit 进行编辑,并根据需要修改,然后进行使用。
修改后记得另存为新的文件,否则下次一旦重新勾选 “Use Memory Layout from Target Dialog”,就会覆盖为原来的文件。
将指定的函数或数据放置到指定的内存区域
实现方式
将函数或变量放置在特定地址,必须将其放置在其自己的节区中。
创建独立源文件
将目标函数或数据单独放在一个文件中,然后在链接脚本中单独引用:
// C代码
// my_function.c - 单独文件存放特定函数
void MyFunction(void) {
    // ...
}

// 链接脚本 (.sct) 中:
ER_SPECIAL 0x10000 0x100 {  // 在0x10000处创建160字节区域
    my_function.o(MyFunction)  // 仅包含该函数
}
使用
__attribute__((at(address)))
直接在变量定义时指定地址(GCC/ARMCC 支持):
// AC5
int my_variable __attribute__((at(0x20000000))) = 42;  // 强制放在RAM地址0x20000000
// AC6
int my_variable __attribute__((section(".ARM.__at_0x20000810"))) = 42;  // 强制放在RAM地址0x20000000
使用
__attribute__((section("name")))
创建命名 section,然后在链接脚本中引用:
// C代码
void MyFunction(void) __attribute__((section("MY_SECTION")));
void MyFunction(void) {
// ...
}

// 链接脚本(.sct)
ER_SPECIAL 0x20000000 0x100 {
    .ANY(MY_SECTION)  // 包含所有MY_SECTION段
}
汇编中的 AREA 指令
在汇编代码中使用 AREA 定义独立区域:
// 汇编代码
AREA MY_SECTION, NOINIT, READWRITE, ALIGN=3  ;创建名为MY_SECTION的代码区,不初始化,可读写,对齐为8字节

// 链接脚本(.sct)
ER_SPECIAL 0x20000000 0x100 {
    .ANY(MY_SECTION)  // 包含所有MY_SECTION段
}
实际应用
et6x.h 文件中定义了如下宏,用于指定代码段加载到指定的内存区域(用户亦可自行定义)
#define __RAM_FUNC __attribute__((section(".RamFunc")))
定义函数时,使用上述宏,即可将函数加载到指定的内存区域。例如:
__RAM_FUNC void func(void)
{
    // Function implementation
}
在链接脚本中,需要将 .RamFunc 段放置到指定的内存区域,例如:
LR_IROM1 0x08000000 0x00040000  {    ; load region size_region
    ER_IROM1 0x08000000 0x00040000  {  ; load address = execution address
        *.o (RESET, +First)
        *(InRoot$$Sections)
        .ANY(+RO)
        .ANY(+XO)
        }
        RW_IRAM1 0x20000000 0x00008000  {  ; RW data
        .ANY(.RamFunc)
        .ANY(+RW +ZI)
        }
}
备注
在使用 armlink 时,需要确保链接脚本中包含了 .RamFunc 段的定义,否则函数会被默认加载到 .ANY 区域(即未指定区域,如上述代码中若未添加 .ANY(.RamFunc),则函数会被加载到 ER_IROM1 中)。
四、map文件分析与运用
.map文件本质上是链接器在链接过程中生成的记录文件,它详细记录了目标文件链接后的内存分配情况、符号信息、段信息等内容。 通过对.map文件的分析,开发者可以清晰地了解程序在内存中的具体布局,知晓各个函数、变量占用的内存空间以及存储位置,从而为代码优化、内存管理、问题排查等工作提供有力支持。
map文件生成
使用MDK进行编译时,默认会生成.map文件。在MDK的工程选项中,可以设置生成.map文件的位置、名称以及输出包含的信息等。
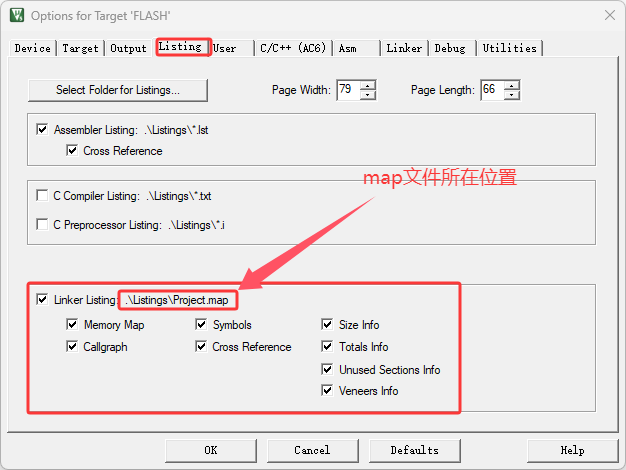
map 文件分析
Section Cross References(交叉引用)
记录程序中各函数、变量之间的引用关系。例如,某个源文件(如main.o)中的函数(如assert_failed)引用了其他文件(如et6x_gpio.o)中的函数(如GPIO_togglePin)或数据段。
用于分析代码依赖关系,排查链接错误或优化未使用的功能模块。
Removing Unused input sections from the image(从镜像中移除未使用的输入段)
通过移除编译过程中未被实际引用的代码段和数据段,减少最终生成的可执行文件占用的存储空间。
Image Symbol Table(镜像符号表)
记录了程序中所有符号(函数、变量、段等)的地址、类型和属性,是调试、内存分析和符号解析的重要依据。
Memory Map of the image(镜像内存映射)
展示程序在物理内存中的具体布局。它详细记录了各个段(Section)的加载地址、运行地址、占用空间、属性等信息,是分析内存使用情况、优化资源分配的关键依据。
在修改内存布局时,可以结合.map文件,分析实际加载和运行地址与预期配置是否一致,从而进行优化。
其中类型栏中可能会出现 PAD,表示该区域为填充区域,用于对齐或填充未使用的内存空间。
Image component sizes(镜像组件大小)
展示程序各组件(代码段、数据段、未初始化段等)占用的存储空间大小。
汇总形式呈现内存使用情况,帮助开发者快速定位内存占用情况,优化程序体积。
以下是 map 文件中 Image component sizes 的部分内容的示例:
Code (inc. data)   RO Data   RW Data    ZI Data      Debug
3712        1580        19        44      10200       7436   Object Totals
0              0        16         0          0          0   (incl. Generated)
0              0         3         0          0          0   (incl. Padding)
21376        648       805         4        300      10216   Library Totals
0              0         6         0          0          0   (incl. Padding)
===============================================================================
Code (inc. data)   RO Data    RW Data    ZI Data      Debug
25088       2228       824         48      10500      17652   Grand Totals
25088       2228       824         48      10500      17652   ELF Image Totals
25088       2228       824         48          0          0   ROM Totals
===============================================================================
Total RO  Size (Code + RO Data)             25912 (  25.30kB)
Total RW  Size (RW Data + ZI Data)          10548 (  10.30kB)
Total ROM Size (Code + RO Data + RW Data)   25960 (  25.35kB)
各字段的含义如下:
字段名称 |
说明 |
示例值 |
|---|---|---|
Code (inc. data) |
显示代码占用 的字节数,包含内联数据( 如字面量池、短字符串)。 |
3712 字节(含 1580 字节内联数据) |
RO Data |
显示只读 数据占用的字节数,独立于 Code 中的内联数据。 |
19 字节(目标文件) + 805 字节(库文件) = 824 字节 |
RW Data |
显示已初始 化读写数据占用的字节数。 |
44 字节(目标文件) + 4 字节(库文件) = 48 字节 |
ZI Data |
显示零 初始化数据占用的字节数( 运行时由系统自动清零)。 |
10200 字节(目标文件) + 300 字节(库文件) = 10500 字节 |
Debug |
显示调试数据 占用的字节数(如符号表、 字符串表、调试输入段)。 |
7436字节(目标文件) + 10216 字节(库文件) = 17652字节 |
Object Totals |
显示链接生成镜像的 目标文件占用的总字节数。 |
分字段显示 |
(incl. G enerated) |
显示链接器生成 的内容(如互操作转接代码 、区域表)占用的字节数。 |
16 字节(RO 数据中的链接器生成内容) |
Library Totals |
显 示从库中提取并添加到镜像 的库成员占用的总字节数。 |
分字段显示 |
(incl. Padding) |
显示为强制 段对齐插入的填充字节数。 |
3 字节(目标文件 RO 数据) + 6 字节(库文件 RO 数据) = 9 字节 |
Grand Totals |
显示镜像的实际 总大小(包含所有字段)。 |
分字段显示 |
ELF Image Totals |
显示启用 RW 数据压缩后的镜像大 小(用于对比压缩效果)。 |
未启用压缩时与 Grand Totals 一致 |
ROM Totals |
显示存储镜像所需的最小 ROM 大小(不含 ZI 数据和 Debug 信息)。 |
分字段显示(计算逻辑:Code + RO + RW + 填充) |
五、堆栈使用情况检测
在嵌入式开发中,堆栈是程序运行时重要的内存区域,用于存储局部变量、函数调用信息(如返回地址、参数)等。 由于嵌入式系统资源相对有限,堆栈空间通常较小,堆栈使用不当可能导致内存溢出、程序崩溃等严重问题。 对堆栈使用情况进行有效检测,及时发现潜在风险并优化堆栈配置,是保障嵌入式系统稳定运行的关键环节。
查看堆栈使用情况
方法一: 添加程序代码,通过调试工具查看堆栈使用情况。
修改启动文件(.s),添加栈内存初始化代码
; Reset handler
Reset_Handler   PROC
                EXPORT  Reset_Handler             [WEAK]
                IMPORT  SystemInit
                IMPORT  __main

                LDR     R0, =__Vectors
                LDR     R1, =0xE000ED08 ;*VTOR register
                STR     R0,[R1]

                ;/******************添加部分***********************/
                ; Fill Stack_Mem with 0xDEADDEAD
                LDR R0, =Stack_Mem ; Start address of stack
                LDR R1, =Stack_Size ; Size of stack in bytes
                LDR R2, =0xDEADDEAD ; Pattern to fill
fill_stack_loop
                STR R2, [R0], #4 ; Store pattern and increment by 4
                SUBS R1, R1, #4 ; Decrement counter by 4 bytes
                BNE fill_stack_loop ; Continue until done
                ;/******************添加部分***********************/

                ;* C routines are likely to be called. Setup the stack now
                LDR     SP,=__initial_sp

                LDR     R0, =SystemInit
                BLX     R0
                LDR     R0, =__main
                BX      R0
                ENDP
在 sct文件中, 单独定义一个Section字段存放stack , 并设置为UNINIT, 既不需要编译器初始化为全0
RW_IRAM2 0x20000000 UNINIT 0x00000800  {  /* (2KB) */
   *.o(STACK)
}
在main.c里,添加如下代码, 函数calc_max_stack_usage 返回值为已使用stack 百分比
extern unsigned int STACK$$Base;
extern unsigned int STACK$$Limit;
static uint32_t calc_max_stack_usage()
{
    uint32_t cnt = 0;
    uint32_t sz = (uint32_t)&STACK$$Limit - (uint32_t)&STACK$$Base;
    while(cnt < sz)
    {
        if(*(uint32_t*)(&STACK$$Base + cnt++) != 0xDEADDEAD)
        break;
    }
    return (sz-cnt*4)*100/sz;
}
调用
calc_max_stack_usage函数, 既可获取到使用stack 百分比。
备注
该方式为通过检测栈区域初始化的数据是否被修改来查看使用情况,所有调用所返回的仅为调用函数之前已使用的stack 百分比。(适用与查看某阶段栈的最大使用情况)
方法二: 查看map文件输出信息。
在Linker中添加如下信息
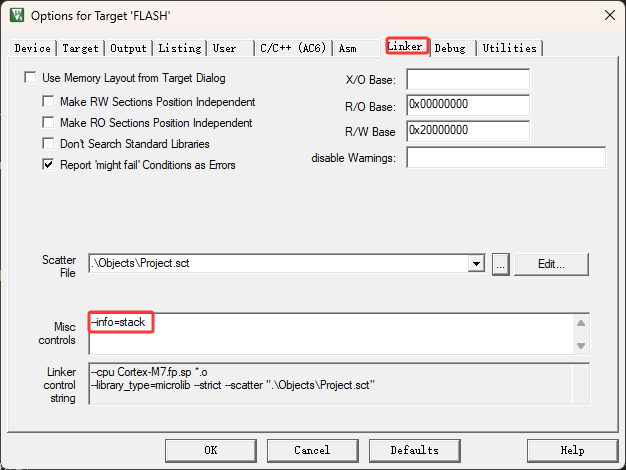
编译后,查看map文件,查找 Image Stack Usage Information.,即可看到堆栈使用情况。该方式可以直接查看整个工程中栈的使用情况。
以下是map文件中的部分内容:
Image Stack Usage Information.

Maximum stack usage for Image.

Maximum Stack Usage for main 0x608 bytes.
Call chain for maximum stack usage:
main => satck_test2

Maximum stack usage per global function.
通过map文件即可查看工程中栈的最大使用情况,以及调用情况。如上述map文件信息中,最大使用情况为 main 函数,使用量为 0x608 字节,调用链为 main => satck_test2。
通过该方式,可以查看工程中栈的使用情况,以及调用情况,便于排查栈溢出问题。
栈溢出问题排查及解决
排查方法:通过 查看堆栈使用情况,确定堆栈使用情况是否超出限制。
问题分析:若分散加载文件中未指定栈空间位置,链接器可能将其分配到与其他未定义区域重叠的位置,运行是若栈溢出,则可能破坏其他数据,导致程序异常。此时调试很难找到问题所在。
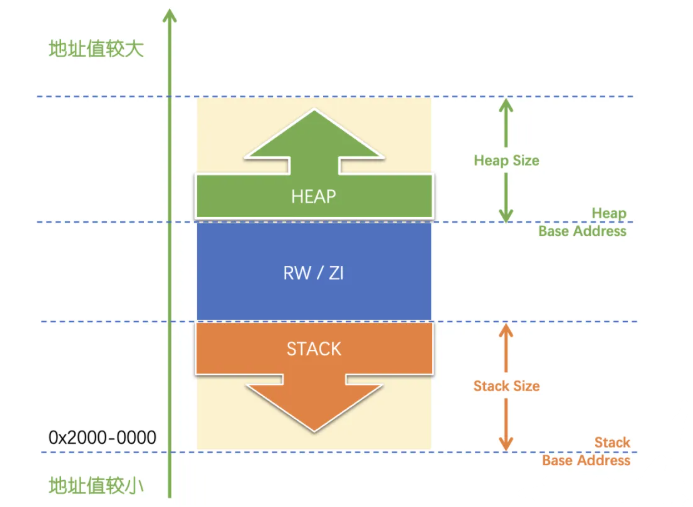
解决方法: 在分散加载文件中,将堆、栈空间指定一个独立的区域(栈放置在存储器底部,堆放置在顶部),并设置堆栈大小。 由于栈是向下生长的,此时若产生栈溢出,就会触发HardFault,便于调试发现问题所在。 堆是向上生长的,当动态内存分配请求超过剩余堆空间时,内存分配函数会返回
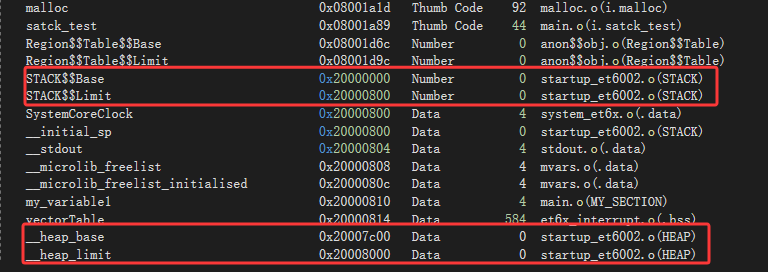
NULL,避免无效内存访问, 若分配成功后出现向上越界(即访问地址超过开辟空间),若越界范围仍在堆区域内,可能导致未使用空间的数据污染;若越界超出堆区域,则会触发HardFault 异常,不至于修改其他区域的数据。验证方法:通过分散加载文件指定独立区域后,查看map文件中堆栈的位置,验证是否为分散加载文件中指定的堆栈空间位置。
堆栈分配方式如下图所示:
分散加载文件实现如下:
#! armclang --target=arm-arm-none-eabi -mcpu=cortex-m0 -E -xc
;*************************************************************
; *** Scatter-Loading Description File generated by uVision ***
; *************************************************************

;/* DTCM = 0x20000000~0x20007FFF   */
#define RAM_BASE    0x20000000
#define RAM_SIZE    0x00008000

#define STACK_SIZE  0x800
#define HEAP_SIZE   0x400
#define IRAM1_SIZE  (RAM_SIZE - STACK_SIZE - HEAP_SIZE)
#define HEAP_BASE   (RAM_BASE + RAM_SIZE - HEAP_SIZE)

LR_IROM1 0x08000000 ALIGN 4 0x00040000   {    /* load region size_region */
ER_IROM1 0x08000000 0x00040000  {  /* load address = execution address */
        *.o (RESET, +First)
        *(InRoot$$Sections)
        .ANY (+RO)
        .ANY (+XO)
    }

    ER_STACK RAM_BASE UNINIT STACK_SIZE  {  /* stack  (2KB) */
        .ANY(STACK)
    }

    RW_IRAM1 +0 IRAM1_SIZE{  /* RW data */
        .ANY(+RW +ZI)
        .ANY(.RamFunc)
    }

    ER_HEAP HEAP_BASE HEAP_SIZE  {  /* heap (1KB) */
        .ANY(HEAP)
    }
}
备注
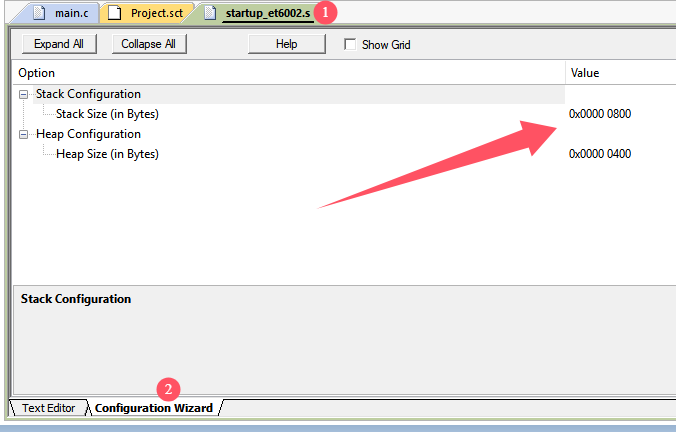
上述代码中的 STACK_SIZE 和 HEAP_SIZE 仅为修改内存布局的空间大小标识,并非实际堆、栈大小。实际堆栈大小在启动文件中定义。
堆栈大小修改方式如下:
备注
堆栈大小设置不能超过实际内存大小(及分散加载文件中定义的堆栈大小),否则分散加载文件中的定义将失效,链接器将自动分配堆栈空间(通常放入ZI段)。
完成堆栈空间分配后,在函数中定义局部变量,使用malloc开辟动态内存,并调用函数,编译后可在map文件中查看堆栈的位置及大小情况。