Keil Optimization Level 选择
最新版本Keil MDK 默认不带有AC5编译器了(可以自己安装AC5),Keil编译器提供了丰富的优化选项,用于平衡代码大小和性能之间的关系。相比AC5,使用AC6会增加几个优化选项:代码大小、速度、平衡等。
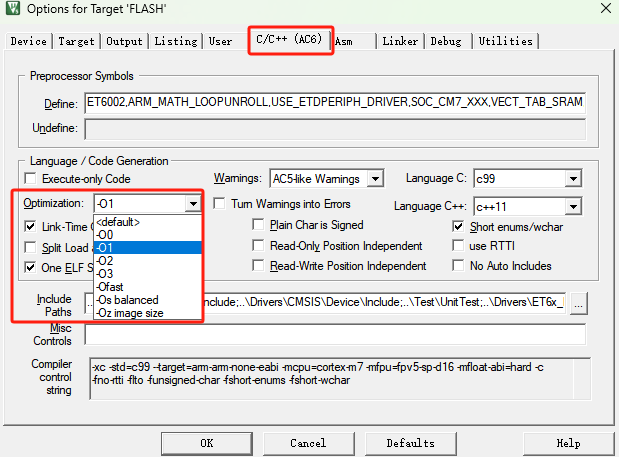
优化选项包含:-O0 -O1 -O2 -O3 -Ofast -Os -Oz -Omax 选项,重点需求:
Optimization goal |
Useful optimization levels |
|---|---|
Smaller code size |
-Os, -O2 |
Faster performance |
-O2, -O3, -Ofast, -Omax |
Good debug experience without code bloat |
-O1 |
Better correlation between source code and generated code |
-O0 |
Faster compile and build time |
-O0 |
Balanced code size reduction and fast performance |
-Os |
优化级别 -O0
特点:
禁用所有优化,编译器不会对代码做任何优化处理,生成的目标代码和源代码的结构、顺序高度一致。
编译器处理流程最简单,编译和链接速度最快。相比其他优化等级(如 -O2、-O3),-O0 的编译时间最短。
与其他优化级别相比,代码大小和堆栈使用率明显更高。
生成的代码与源代码紧密相关,但是生成的代码量更大,包括无用的代码。
与其他优化级别相比,调试体验可能会更好。
与其他优化级别相比,代码质量可能会更好。
与其他优化级别相比,代码大小和性能之间的关系可能会更好。
优化级别 -O1
特点:使用此选项以获得良好的调试体验。
在编译器中启用核心优化。
代码质量好。
堆栈使用率提高。
-O1 做适度优化,调试体验比 -O2、-O3 好,且不会像 -O0 那样完全无优化。
性能可能会更好。
代码大小和性能之间的关系可能会更好。
-O1 与 -O0 相比,使用时的区别是:
启用优化,这可能会降低调试信息的完整度。
启用了内联和尾调用,这意味着回溯可能无法提供打开功能激活的堆栈。
不会调用没有使用,或没有预期调用的函数,代码量更小。
变量的值在不使用后可能在其范围内不可用。例如,它们的堆栈位置可能已被重用。
优化级别 -O2
-O2 会进行较多优化,包括去除冗余代码、循环优化等,通常能减小代码体积,并更改了优化的启发式方法。这是编译器可能生成矢量指令的第一个优化级别,还会降低调试体验。
-O2 与 -O1 相比使用时的差异是:
编译器认为内联调用站点可获利的阈值可能会增加。
执行的循环展开数量可能会增加。
可以为简单循环和独立标量运算的相关序列生成矢量指令【矢量指令(Vectorization) 是编译器自动将标量操作转化为SIMD(单指令多数据)指令的过程,可以提升数据并行处理的效率】。
可以使用 armclang 命令行选项禁止创建矢量指令 -fno-vectorize。-fno-vectorize 用于编译器自动进行矢量化优化,默认情况下,较高优化等级(如 -O2、-O3)会自动启用矢量化。
某些情况下,自动矢量化可能导致代码行为异常或调试困难,此时可以用 -fno-vectorize 禁止,生成的代码不会包含自动矢量化的 SIMD 指令。
优化级别 -O3
特点:启用更多、更激进的优化选项,目的是最大化程序的执行速度,追求极致性能,适合对速度要求极高的场合,选择时需根据实际需求权衡。
有更高的性能优化。
允许进行需要大量编译时分析和资源的优化(对性能要求极高的核心算法、数值计算、信号处理等)。
与 -O2 相比更改了优化的启发式方法。
-O3 指示编译器针对生成的代码的性能进行优化,由于循环展开、内联等激进优化,而忽略生成的代码的大小。
代码大小增加,可能不适合资源受限的嵌入式系统。
-O3 与 -O2 相比使用时的差异是:
编译器认为内联调用站点是有利可图的阈值增加。
执行的循环展开量增加。
在编译器管道中启用更积极的指令优化。
优化级别 -Os
特点:-Os 目的是在不显著增加代码大小的情况下提供高性能。根据你的应用程序,提供的性能可能类似于 -O2 或 -O3。
-Os 与 -O3 相比,可减少代码大小。但会降低调试体验。
-Os 与 -O3 相比使用时的差异是:
降低编译器认为内联调用站点可获利的阈值。
显著降低了执行的循环展开量。
优化级别 -Oz
特点:-Oz 目的是提供尽可能小的代码量。Arm 建议使用此选项以获得最佳代码大小,此优化级别会降低调试体验。
-Oz 与 -Os 相比使用时的差异是:
编译器仅针对代码大小进行优化,而忽略性能优化,这可能会导致代码变慢。
未禁用功能内联。在某些情况下,内联可能会整体上减少代码大小,例如,如果一个函数仅被调用一次。仅当预期代码大小会减小时,才将内联启发式方法调整为内联式。
禁用可能会增加代码大小的优化,例如循环展开和循环矢量化。
循环是作为 while 循环而不是 do-while 循环生成的。
优化级别 -Ofast
特点:
包含了 -O3 的所有优化内容,如循环展开、矢量化、函数内联、常量传播等。
-Ofast 通常会自动启用 -ffast-math,这会让编译器对浮点运算做更激进的优化,如合并表达式、忽略浮点运算的精度和舍入方式等。
-Ofast 会启用一些默认情况下不会开启的优化,这些优化可能会让程序的行为不完全符合 C/C++ 标准,但能进一步提升性能。
与 -O3 相比,该级别会降低调试体验,并可能导致代码大小增加。
优化级别 -Omax
-Omax 是最大程度的优化,并专门针对性能优化。它支持从级别进行的所有优化,以及链接时间优化(Link-time Optimization LTO)。
在此优化级别上,ARM Compiler 可能会违反严格遵守语言标准的规定。使用此优化级别可获得最快的性能。
与 -Ofast 相比,该级别会降低调试体验,并可能导致代码大小增加。
使用 -Omax 进行编译,并具有单独的编译和链接步骤,必须在 armlink 命令行中包括 -Omax。
- 编译时用 -Omax,但链接时没加,链接器可能不会应用最高级别的优化,导致最终生成的程序没有达到期望的优化效果,甚至可能出现兼容性或性能问题。
备注
在coremark测试中需要注意对应配置,避免测试数据未达预期;
优化项选择对比
优化级别 |
主要目标 |
优化强度 |
代码体积 |
调试友好性 |
适用场景 |
|---|---|---|---|---|---|
-O0 |
无优化 |
最低 |
最大(无任何优化) |
最好 |
调试、开发初期 |
-O1 |
基本优化 |
低 |
较大(略小于-O0) |
较好 |
需调试且有一定优化需求 |
-O2 |
高级优化 |
中 |
中等(通常小于-O1) |
一般 |
正式发布、性能与体积平衡 |
-O3 |
最高级别优化 |
最高 |
较大(可能大于-O2/-Os) |
最差 |
性能极致要求(如算法核心) |
-Ofast |
激进优化(不保证标准) |
极高 |
较大(与-O3类似或更大) |
最差 |
极致性能,允许不完全遵循标准的场合 |
-Omax |
编译器支持的最大优化 |
极高 |
较大(与-Ofast类似) |
最差 |
追求极限性能,通常与-Ofast类似 |
-Os |
优化代码体积 |
中 |
小(小于-O2,接近最小) |
一般 |
存储空间有限的嵌入式系统 |
-Oz |
极致优化代码体积 |
中 |
最小(所有等级中最小) |
一般 |
追求最小体积,部分编译器(如clang)支持 |