MDK编译涉及的各文件解析
文档编号:AN0010
在MDK(Microcontroller Development Kit)开发环境中,编译过程会涉及多种类型的文件,这些文件在程序开发、调试和烧录等环节都起着至关重要的作用。下面将对这些文件进行详细解析。
1..s文件
启动文件(Startup File),在MDK开发环境中,通常以 .s 为后缀名,是用汇编语言编写的文件。 它在程序启动过程中承担着至关重要的角色,负责初始化硬件设备、设置系统运行环境,为C/C++代码的执行做好准备。
生成过程
启动文件一般由芯片厂商或开发工具供应商提供,针对特定的芯片型号和架构进行定制。 例如,对于ARM Cortex-M系列芯片,不同型号的启动文件会根据芯片的特性(如中断向量表的位置、内存映射等)进行编写。 开发者也可以根据项目的特殊需求对提供的启动文件进行修改和调整。在创建新的MDK项目时,开发环境会根据所选的芯片型号自动添加相应的启动文件到项目中。
主要内容
中断向量表:中断向量表是启动文件的重要组成部分,它存储了各个中断服务程序的入口地址。 例如,在ARM Cortex-M系列芯片的启动文件中,中断向量表通常位于文件开头,按照固定的顺序排列各个中断的向量。 每个向量对应一个32位的地址,这个地址指向相应的中断服务程序。当中断发生时,处理器会根据中断号在中断向量表中找到对应的地址,并跳转到该地址执行中断服务程序。
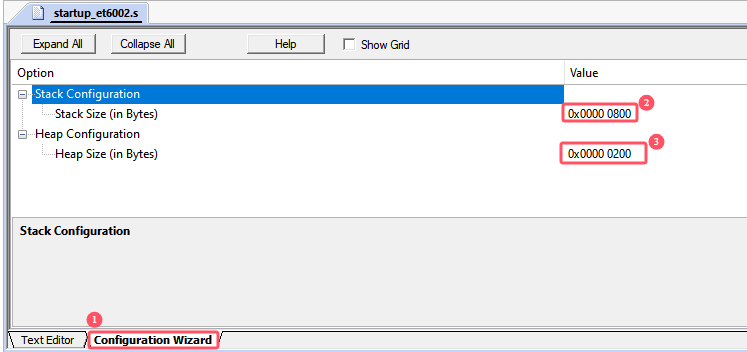
堆栈初始化:启动文件会对堆栈进行初始化操作,包括设置栈指针(SP)和堆指针(若使用堆)。栈指针的设置需根据芯片的内存布局和应用需求确定栈的起始地址和大小。
初始化代码:包含一系列初始化硬件设备和系统环境的代码。这可能包括初始化系统时钟,根据芯片的时钟树结构,设置时钟源、分频器等寄存器,以确保系统时钟达到预期的频率。 还会初始化内存控制器,配置内存的访问时序、大小等参数,使处理器能够正确地访问片内和片外内存。此外,还可能涉及初始化其他关键硬件,如GPIO、UART、SPI等外设。
跳转到主函数:在完成所有的初始化操作后,启动文件会跳转到C/C++代码的主函数( main 函数),将程序的控制权交给应用程序代码。
修改堆栈大小
用途
系统初始化:启动文件负责完成系统启动时的各项初始化工作,确保硬件设备处于正确的工作状态,系统环境满足应用程序的运行要求。 这是保证程序正常运行的基础,任何硬件设备的未初始化或错误初始化都可能导致程序运行异常。
建立运行环境:为C/C++代码的执行建立运行环境,包括堆栈的初始化、中断向量表的设置等。 这些操作使得C/C++代码能够在一个稳定的环境中运行,确保函数调用、局部变量的存储以及中断处理等操作的正常进行。
平台适配:由于不同的芯片型号和架构具有不同的硬件特性和启动要求,启动文件起到了适配平台的作用。 通过编写特定的启动文件,可以将应用程序与具体的硬件平台进行解耦,使得应用程序在不同的平台上具有更好的移植性。
实际应用
嵌入式系统开发:在嵌入式系统开发中,启动文件是必不可少的。例如,在基于ET600X微控制器的项目中,启动文件会根据ET600X芯片的型号和系列进行定制。 开发者可以根据项目需求修改启动文件中的初始化代码,如调整系统时钟频率、配置外设的初始状态等。在开发过程中,如果遇到硬件初始化问题,首先需要检查启动文件中的相关设置。
裸机开发:在不使用操作系统的裸机开发环境中,启动文件的作用更加突出。它需要完成所有的系统初始化工作,包括硬件设备的初始化、内存管理、中断处理等。 启动文件的质量直接影响到整个系统的稳定性和性能。
操作系统移植:当在嵌入式系统中移植操作系统时,启动文件也需要进行相应的修改和适配。 操作系统通常有自己的启动流程和要求,启动文件需要与操作系统的启动机制相配合,完成系统的初始化和控制权的交接。 例如,在移植RT-Thread操作系统到特定的ARM芯片上时,需要对启动文件进行调整,确保操作系统能够正确启动并运行。
2..sct文件
分散加载文件(Scatter-Loading File)。在MDK开发环境中,它用于精确控制程序在内存中的布局,决定代码和数据在不同存储区域(如Flash、RAM)的存放位置。 .sct文件通常由开发者根据项目的硬件资源和内存使用需求手动编写。因为不同的芯片具有不同的内存映射和资源配置,开发者需要依据实际情况来规划程序在内存中的分布。
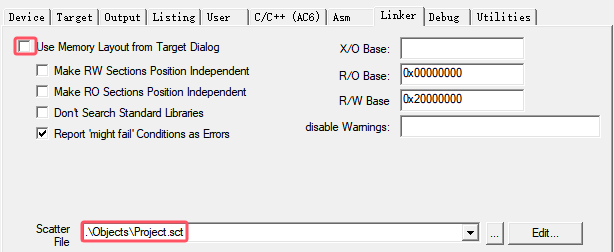
示例
LR_IROM1 0x08000000 0x00040000  {    ; load region size_region
  ER_IROM1 0x08000000 0x00040000  {  ; load address = execution address
   *.o (RESET, +First)
   *(InRoot$$Sections)
   .ANY (+RO)
   .ANY (+XO)
  }
  RW_IRAM1 0x20000000 0x00008000  {  ; RW data
   .ANY (+RW +ZI)
  }
}
主要内容
加载区域(Load Region)定义:使用类似 LR_IROM1 0x08000000 0x00040000 这样的语句定义加载区域。 其中 LR_IROM1 是加载区域的名称,开发者可以自行命名; 0x08000000 是加载区域的起始地址,表明程序在存储介质(如Flash)中的起始位置; 0x00040000 表示加载区域的大小,这里意味着该区域大小为256KB(0x00040000换算为十进制是262144字节,即256KB)。
执行区域(Execution Region)定义:如 ER_IROM1 0x08000000 0x00040000 , ER_IROM1 是执行区域的名称,同样可自定义; 0x08000000 是执行区域的起始地址,即程序运行时的起始地址; 0x00040000 为执行区域的大小。 加载区域和执行区域的地址和大小设置通常与项目所使用的芯片内存布局相关,比如某些芯片的Flash起始地址为0x08000000,开发者就会据此设置相应区域。
- 段分配规则:
*.o (RESET, +First): 表示所有目标文件( .o 文件)中标记为 RESET 的段,并且这些段会被放在执行区域的最开始位置( +First )。这通常用于放置程序启动时必需的代码或数据,比如复位向量表等。
*(InRoot$$Sections):
表示所有名字中包含
InRoot$$Sections的段都被包含在这个执行区域中。$$在链接脚本中用于特定的符号命名约定,常用于组织和区分不同功能或来源的段。.ANY (+RO) :
表示所有具有只读(Read - Only,+RO )属性的段都会被包含在这个执行区域中。这类段通常包含程序的代码(如函数体)和只读数据(如常量字符串、常量数组等)。因为它们在程序运行过程中不会被修改,所以可以存储在只读存储区域,以节省内存空间和提高访问效率。
.ANY (+XO) :
表示所有具有可执行但不加载(eXecute Only,+XO )属性的段会被包含在这个执行区域中。这类段通常是一些特殊的代码段,它们在运行时从存储介质中直接执行,而不需要先加载到其他内存区域。这种特性在一些对内存使用和性能有特殊要求的场景中非常有用,比如一些代码固化在ROM中,直接在ROM中执行,避免了加载到RAM的开销。
.ANY (+RW +ZI) :
表示所有具有读写(Read - Write, +RW )和零初始化(Zero Initialised,
+ZI)属性的段都会被包含在对应的区域中。+RW 段包含了在程序运行时会被修改的数据,例如全局变量和静态变量;+ZI 段包含了未初始化的全局变量和静态变量,这些变量在程序启动时会被初始化为0。这有助于合理管理内存,提高程序的稳定性和可维护性。
用途
内存布局控制:.sct文件最主要的用途就是精确控制程序在内存中的布局。通过合理设置加载区域和执行区域,以及各个段的分配规则,可以确保程序代码和数据能够正确地存储在对应的内存空间中, 满足硬件资源的要求和程序运行的需要。比如在嵌入式开发中,不同类型的数据(如代码、常量、变量)需要存储在不同的内存区域(如Flash、RAM),.sct文件就可以实现这种精细的控制。
优化程序性能:合理的内存布局可以提高程序的执行效率。例如,将经常访问的数据和代码放置在快速访问的内存区域(如内部RAM),可以减少内存访问时间,从而提升程序的整体性能。 通过.sct文件,开发者可以根据程序的运行特点和硬件资源进行优化配置。
实际应用
嵌入式系统开发:在嵌入式系统开发中,由于硬件资源有限,并且不同的芯片具有不同的内存架构,.sct文件的作用尤为重要。 例如,在基于ARM Cortex-M系列芯片的开发中,开发者需要根据芯片的Flash和RAM大小及地址范围,编写.sct文件来合理分配程序代码和数据的存储位置。 如果项目需要将一部分代码放置在外部Flash中,另一部分代码和数据放置在内部RAM中,就可以通过.sct文件进行精确配置。
代码移植和复用:当项目需要移植到不同的硬件平台时,.sct文件可以方便地进行修改以适应新平台的内存布局。 同时,在多个项目中,如果有相似的内存使用需求,可以复用已有的.sct文件,提高开发效率。
3..ini文件
为了确保程序加载到 RAM 并可以进行调试,需要在调试选项卡中进行以下更改。 该文件用于初始化调试会话,并在“初始化文件”字段中提供其路径。
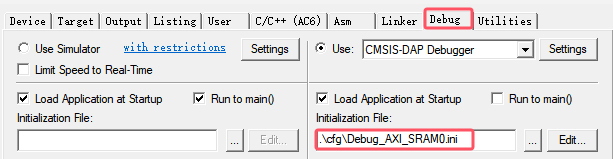
示例
下面是一段包含调试环境初始化、复位执行逻辑以及下载命令的代码:
/* 该函数的主要作用是进行调试环境的初始化设置,为程序的运行做好准备。*/
FUNC void Setup (void) {
  SP = _RDWORD(0x20400000);             // Setup Stack Pointer
  PC = _RDWORD(0x20400004);             // Setup Program Counter
  XPSR = 0x01000000;                    // Set Thumb bit
  _WDWORD(0xE000ED08, 0x20400000);
}

/* 在软件复位(`RESET`)时执行,其主要作用是调用 `Setup` 函数,在复位后进行必要的初始化设置,为程序的运行做好准备。*/
FUNC void OnResetExec (void) {          // executes upon software RESET
 Setup();                               // Setup for Running
}

/*
* `LOAD` 是 MDK 中的命令,用于将程序下载到目标设备的内存中。
* `%L` 是一个占位符,表示当前要加载的可执行文件。
* `INCREMENTAL` 表示增量下载,即只下载那些在上次下载后发生了变化的部分,这样可以提高下载速度。
*/
LOAD %L INCREMENTAL                     // Download to RAM
Setup();

/* 调试器在完成下载和初始化后,跳转到 `main` 函数开始执行程序。*/
//g, main
用途
该 .ini 文件主要包含了两个自定义函数 Setup 和 OnResetExec,以及一些用于程序下载和执行的命令。这些内容共同完成了调试环境的初始化和程序的启动操作。
实际应用
在嵌入式系统开发中,当需要在内部 RAM 中调试程序时,这个 .ini 文件就非常有用。通过设置栈指针、程序计数器和 Thumb 位,以及下载程序和启动程序, 开发者可以方便地在 RAM 中运行和调试代码,避免了频繁烧录到 Flash 中的麻烦。同时,增量下载功能可以提高调试效率,特别是在代码修改频繁的情况下。
4..axf文件
ARM Executable File,即ARM可执行文件。
生成过程
.axf 文件(ARM Executable File)由链接器生成。在编译阶段,编译器先将各个源文件分别编译成目标文件(.o 文件),这些目标文件包含对应源文件的机器代码、符号表以及重定位信息等。 之后,链接器会把这些目标文件和程序所依赖的库文件(.lib 文件)链接在一起,整合形成一个完整的可执行文件。 若在开发过程中启用了调试选项,链接器还会在生成的.axf 文件中包含调试信息,这些信息对后续的程序调试至关重要。
主要内容
代码段(Text Section):存放程序的机器指令,这是程序运行的核心部分,处理器会按照代码段中的指令顺序执行,完成各种功能。
数据段(Data Section):用于存放初始化的全局变量和静态变量。例如在C语言中,定义为 int global_var = 10; 的变量就会存储在数据段,其初始值10也会保存在这里。
BSS段(BSS Section):存储未初始化的全局变量和静态变量。在程序启动时,BSS段中的变量会被自动初始化为0,这样可以节省可执行文件的存储空间。
调试信息:包含源代码行号、变量名、函数名等。在调试时,这些信息可以帮助开发者将机器指令与源代码对应起来,方便查看变量值、设置断点以及单步执行程序。
符号表:记录程序中所有符号(函数、变量)的地址信息。链接器在链接过程中,通过符号表来解决符号引用问题,确保程序中各个模块之间的正确调用和数据访问。
重定位信息:用于动态加载时修正地址。由于在链接时,部分符号的地址可能是相对地址或者尚未确定,在程序加载到内存运行时,需要根据重定位信息来修正这些地址,保证程序的正确运行。
用途
用于调试:通过JTAG(Joint Test Action Group)或SWD(Serial Wire Debug)接口,.axf文件可以下载到目标设备中。 在MDK的调试环境中,加载.axf文件后,开发者能够设置断点、查看变量值、单步执行程序等,方便对程序进行调试和验证。
格式转换:借助工具(如 fromelf ),.axf文件可以转换为其他格式,如.hex或.bin文件,以满足不同烧录工具和目标设备的需求。
实际应用
调试阶段:在开发过程中,当需要调试程序时,MDK会自动加载.axf文件到调试器。 开发者可以在源代码中方便地设置断点,当程序运行到断点处暂停时,就能查看变量的值、寄存器的状态等信息,从而逐步排查程序中的错误。
生产环境:在产品的生产阶段,由于.axf文件包含调试信息,体积较大,不适合直接烧录到目标设备的Flash中。 此时,可以使用 fromelf 工具将.axf文件转换为.hex或.bin文件,然后使用相应的烧录工具将其烧录到目标设备。
5..hex文件
生成过程
.hex文件通常是通过 fromelf 工具从.axf文件生成的。 fromelf 工具会读取.axf文件中的代码段、数据段等信息,并按照Intel HEX文件的格式规范进行转换,生成最终的.hex文件。
主要内容
起始地址(Start Address) :记录了程序的起始执行地址,目标设备在加载程序时,会从这个地址开始读取指令并执行。
数据记录(Data Records) :程序的机器代码以多行数据记录的形式存储,每行包含地址、数据和校验和。 地址表示该行数据在目标设备内存中的存储位置,数据是实际的机器代码,校验和用于验证该行数据在传输或存储过程中是否出现错误。 例如, :10010000214601360121470136007EFE09D2190140 ,其中 10 表示数据长度, 0100 表示地址, 214601360121470136007EFE09D21901 是数据, 40 是校验和。
结束记录(End Record) :以特定的格式(如`:00000001FF`)标识文件的结束,烧录工具读取到结束记录时,就知道文件读取完毕。
用途
烧录到目标设备:.hex文件主要用于烧录到目标设备的Flash中,为设备提供可执行的程序代码。
支持多种烧录工具:许多烧录工具(如J-Flash、ST-Link Utility等)都支持Intel HEX格式的文件,方便开发者使用不同的烧录工具进行程序烧录。
实际应用
生产环境:在产品的大规模生产过程中,烧录工具可以直接读取.hex文件并将其写入目标设备的Flash中。由于.hex文件包含地址信息,烧录时无需额外指定地址,简化了烧录过程,提高了生产效率。
远程升级:在一些需要远程升级程序的应用场景中,.hex文件可以通过网络传输到目标设备,然后使用设备自带的烧录功能将.hex文件写入Flash中,实现程序的远程升级。
6..bin文件
生成过程
.bin文件也是通过 fromelf 工具从.axf文件生成的。 fromelf 工具会提取.axf文件中的代码段和数据段等实际的机器代码部分,将其按照顺序排列并保存为二进制文件,即.bin文件。
主要内容
.bin文件只包含程序的机器代码,这些代码按顺序排列,不包含任何地址信息。因此,在烧录.bin文件时,需要额外指定烧录地址,以确保代码被正确地写入目标设备的Flash中。
用途
烧录到目标设备:.bin文件用于烧录到目标设备的Flash中,为设备提供可执行的程序代码。
适合批量生产:由于.bin文件是纯二进制格式,不包含额外的信息,文件体积相对较小,烧录速度快,因此适合在大规模生产环境中使用。
实际应用
生产环境:在产品的批量生产过程中,使用.bin文件进行烧录可以提高烧录速度,降低生产成本。 烧录工具需要指定烧录地址(通常为Flash的起始地址),将.bin文件中的机器代码准确地写入目标设备的Flash中。
存储和传输:由于.bin文件体积小,便于存储和传输。在一些资源受限的环境中,如通过无线网络传输程序代码时,使用.bin文件可以减少传输的数据量,提高传输效率。
7..map文件
Memory Map文件,即内存映射文件。
生成过程
.map文件由链接器在链接过程中生成。链接器在将各个目标文件和库文件链接在一起时,会确定每个符号的最终内存地址,并记录每个代码段、数据段等的起始地址和大小。 然后,链接器将这些信息整理成.map文件,方便开发者查看和分析程序的内存使用情况。
主要内容
符号表:记录了函数、全局变量等符号的地址和大小。通过符号表,开发者可以了解每个符号在内存中的具体位置,以及它们占用的内存空间大小。 例如,符号表中可能会显示某个函数的起始地址和结束地址,以及某个全局变量的存储地址和占用的字节数。
段信息:包含代码段、数据段、未初始化数据段(BSS段)等的起始地址和大小。段信息可以帮助开发者了解程序的内存布局,例如代码段占用了多少内存空间,数据段和BSS段分别存储了哪些数据。
内存使用统计:统计各段的内存占用情况,包括每个段的起始地址、结束地址、大小等信息。通过内存使用统计,开发者可以分析程序的内存使用是否合理,是否存在内存浪费或不足的情况。
用途
分析内存使用情况:开发者可以通过.map文件查看程序中各个符号和段的内存占用情况,分析内存使用是否合理。 例如,如果发现某个函数占用了大量的内存空间,可以考虑对该函数进行优化,减少内存开销。
排查内存冲突:当程序出现内存冲突问题时,.map文件可以帮助开发者定位冲突的位置。 通过查看符号表和段信息,开发者可以发现是否存在不同的符号或段占用了相同的内存地址,从而解决内存冲突问题。
优化程序的内存布局:根据.map文件中的内存使用情况,开发者可以调整链接脚本,改变代码段、数据段等的内存布局,优化内存使用,提高程序的性能。
实际应用
调试阶段:在程序调试过程中,如果出现内存相关的问题,如栈溢出、内存泄漏等,开发者可以通过查看.map文件来分析问题的原因。 例如,如果发现栈空间不足导致栈溢出,可以通过调整栈的大小或优化函数调用方式来解决问题。
优化阶段:在程序优化过程中,开发者可以根据.map文件中的内存使用统计信息,对程序进行优化。 例如,将不常用的数据存放在外部存储器中,减少内部存储器的占用;或者调整代码段和数据段的布局,提高内存的访问效率。
8..lst文件
Listing文件,即列表文件。
生成过程
.lst文件由编译器在编译过程中生成。编译器在将源代码编译成机器代码的同时,会将源代码、生成的汇编代码以及对应的机器代码按照一定的格式整理成.lst文件。 通过.lst文件,开发者可以直观地看到源代码与汇编代码、机器代码之间的对应关系。
主要内容
源代码行号:每行源代码对应的行号,方便开发者在.lst文件中定位源代码的位置。通过行号,开发者可以快速找到某个源代码行对应的汇编代码和机器代码。
生成的汇编指令:编译器将源代码编译成的汇编代码。汇编代码是一种中间表示形式,它更接近机器代码,能够反映出编译器对源代码的处理过程和优化策略。 例如,对于C语言中的`for`循环语句,编译器可能会将其编译成一系列的汇编指令,如跳转指令、比较指令等。
机器代码的十六进制表示:每条汇编指令对应的机器代码的十六进制表示。 机器代码是可以直接被处理器执行的二进制代码,通过查看机器代码的十六进制表示,开发者可以了解汇编指令在机器层面的具体实现。
用途
分析程序的执行细节:开发者可以通过.lst文件查看源代码对应的汇编代码和机器代码,深入了解程序的执行细节。 例如,分析函数的调用过程、变量的存储和访问方式等,从而更好地理解程序的运行机制。
帮助优化代码性能:通过查看.lst文件中的汇编代码,开发者可以发现代码中可能存在的性能瓶颈。 例如,某些指令的执行效率较低,或者存在不必要的指令重复等问题。开发者可以根据这些信息对源代码进行优化,提高程序的性能。
实际应用
代码优化:在优化代码时,开发者可以通过.lst文件查看编译器生成的汇编代码,分析性能瓶颈。 例如,如果发现某个函数的汇编代码中存在大量的跳转指令,可能会影响程序的执行效率,开发者可以考虑对该函数进行重构,减少跳转指令的使用。
调试:在调试过程中,当遇到难以理解的程序行为时,开发者可以结合.lst文件中的汇编代码和机器代码进行分析,定位问题的根源。 例如,通过查看汇编代码可以了解变量的存储和访问方式,从而找出变量值异常的原因。
9..o文件
Object文件,即目标文件。
生成过程
.o文件由编译器生成,是编译单个源文件后的目标文件。在编译过程中,编译器对每个源文件(如 .c 、 .cpp 文件)进行词法分析、语法分析、语义分析、代码生成等步骤,
最终将源代码转换为机器代码,并生成对应的.o文件。同时,编译器会记录源文件中定义的函数和变量等符号信息,以及链接时需要修正的地址信息(重定位信息)。
主要内容
代码段:源文件生成的机器代码,即经过编译器编译后得到的可以被处理器执行的二进制代码。代码段包含了源文件中定义的函数的实现代码,以及其他可执行的逻辑。
符号表:记录了源文件中定义的函数和变量等符号信息。符号表包含了符号的名称、类型、地址等信息,链接器可以根据符号表来解决符号引用问题,将各个目标文件中的符号引用与定义进行匹配。
重定位信息:由于在编译单个源文件时,无法确定某些符号的最终地址,因此需要记录重定位信息。重定位信息用于在链接过程中修正这些符号的地址,确保程序在链接后能够正确运行。
用途
.o文件是链接过程的中间文件,链接器会将这些文件合并生成最终的可执行文件(如.axf文件)。通过将源文件分别编译成目标文件,可以提高编译效率, 特别是在大型项目中,当某个源文件发生修改时,只需要重新编译该源文件对应的目标文件,而不需要重新编译整个项目。
实际应用
在大型项目中,通常包含多个源文件和头文件。每个源文件编译后生成一个.o文件,链接器将这些.o文件和库文件合并为一个可执行文件。 例如,一个嵌入式系统项目可能包含多个模块,每个模块由多个源文件组成,每个源文件编译后生成一个.o文件,最后通过链接器将所有的.o文件和库文件链接在一起,生成最终的可执行文件。
10..d文件
Dependency文件,即依赖文件。
生成过程
.d文件由编译器在编译源文件时生成。编译器在编译源文件的过程中,会分析源文件中包含的头文件,并记录这些头文件的信息,生成.d文件。.d文件的生成过程是自动的,开发者不需要手动干预。
主要内容
源文件名:记录了生成该.d文件的源文件的名称。
依赖的头文件列表:列出了源文件所依赖的所有头文件的名称。
用途
.d文件用于增量编译,确保头文件修改后相关源文件能重新编译。在大型项目中,头文件的修改可能会影响到多个源文件,如果每次都重新编译所有源文件,会耗费大量的时间。 而.d文件记录了源文件与头文件之间的依赖关系,当某个头文件被修改时,编译器可以根据.d文件快速确定哪些源文件需要重新编译,提高编译效率。
实际应用
在大型项目开发中,当修改了某个头文件后,编译器会读取.d文件,找到依赖该头文件的源文件,并对这些源文件进行重新编译。这样可以避免不必要的编译操作,节省编译时间,提高开发效率。
11..crf文件
Cross-Reference文件,即交叉引用文件。
生成过程
.crf文件由编译器生成,在编译过程中,编译器会收集和整理符号的定义和引用信息,生成包含符号交叉引用信息的.crf文件。
符号名:记录了程序中所有符号(函数、变量等)的名称。
符号的定义位置和引用位置:对于每个符号,.crf文件会记录其在源文件中的定义位置以及在其他源文件中的引用位置。通过这些信息,开发者可以清晰地了解符号在整个项目中的使用情况。
用途
.crf文件用于查找符号的定义和引用位置。在大型项目中,代码量较大,符号的定义和引用关系复杂,通过.crf文件可以快速定位某个符号的定义和引用位置,方便开发者进行代码阅读、维护和调试。
实际应用
在大型项目开发过程中,当开发者需要查看某个函数或变量的定义和使用情况时,可以通过.crf文件快速找到其定义位置和所有引用该符号的位置。这有助于理解代码的逻辑结构,快速定位和解决问题。